Инфраструктура
Grafana Loki для малого бизнеса
Материал подготовлен с участием ИИ, проверен редакцией.
Логи обычно вспоминают в момент, когда уже поздно спокойно разбираться. Сайт не отправляет заявки, кассовый модуль ругается на интеграцию, 1С «периодически подвисает», а в ответ слышно: «надо смотреть журналы». Хорошо, если журналы на месте, не перетёрты ротацией и кто-то понимает, где искать. Плохо, если каждый сервис пишет в свой угол, доступ есть только у одного администратора, а нужный файл исчез ночью.
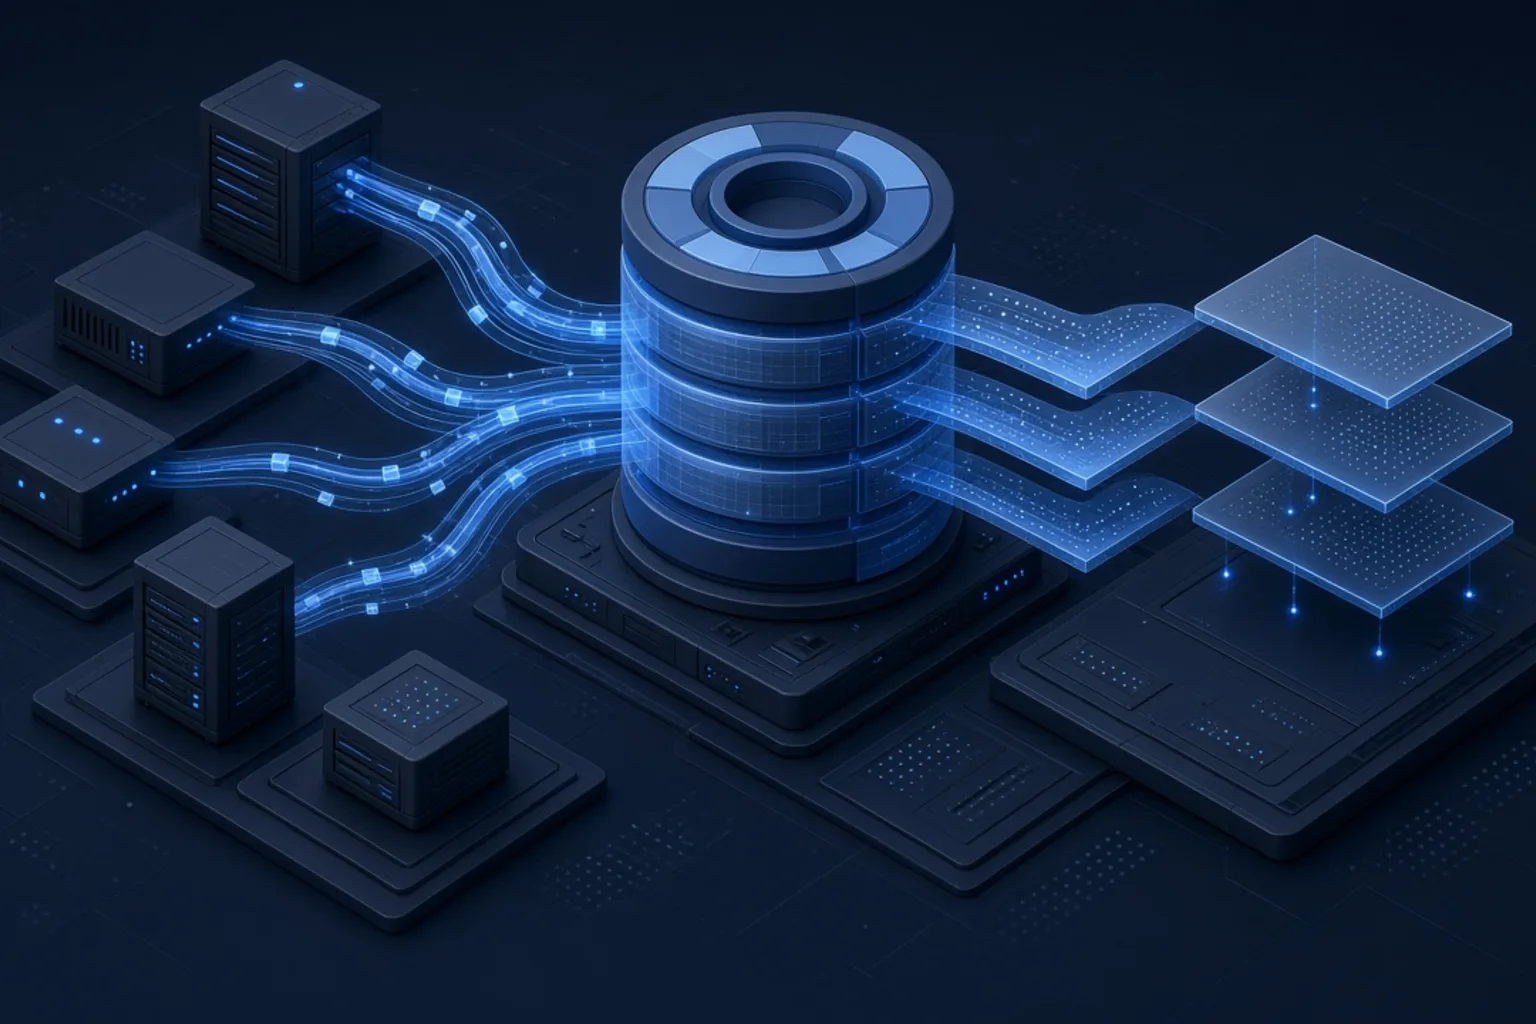
Централизованные логи — не игрушка для больших корпораций. Но и ставить тяжёлый ELK только потому, что «так принято», малому бизнесу часто не нужно. Grafana Loki занимает полезную середину: он собирает текстовые логи, хранит их сравнительно экономно и дружит с Grafana, где уже могут жить метрики мониторинга.
Главный вопрос не «какой стек моднее», а какую проблему вы хотите быстрее расследовать.
Когда хватит journald и файлов
Если у вас один VPS с сайтом-визиткой, почтой или небольшим приложением, не надо начинать с кластера логирования. Часто достаточно нормальной ротации файлов, journald, понятных путей и доступа для подрядчика по администрированию серверов.
Минимальный порядок уже сильно помогает: системные службы пишут в журнал, Nginx хранит access/error logs, приложение не смешивает ошибки с отладочным шумом, ротация не удаляет всё через пару дней, а время на сервере синхронизировано. Когда случается сбой, администратор открывает один хост и видит картину.
Для малого бизнеса это не «бедный вариант», а нормальный уровень, если инфраструктура простая. Централизация нужна не ради красивого интерфейса, а когда локального просмотра становится мало.
Признаки, что пора собирать логи централизованно
Первый признак — несколько серверов и площадок. Например, сайт на VPS, 1С на отдельном хосте, VPN для удалённых клубов, NVR или сервис интеграции с CRM. Ошибка проходит цепочку, и каждый раз приходится прыгать между машинами.
Второй признак — повторяющиеся «плавающие» проблемы. Днём всё работает, вечером форма записи иногда падает, утром лог уже перезаписан. Или на одной площадке гости жалуются на авторизацию в Wi‑Fi, но в момент подключения специалиста проблема исчезает.
Третий признак — нужны не только аварии, но и история. Кто часто получает 500-е ошибки, какой endpoint шумит, когда начались отказы после обновления, что происходило за несколько минут до падения сервиса. Тут централизованный поиск экономит часы.
В мониторинге инфраструктуры метрики отвечают на вопрос «что болит». Логи чаще отвечают «почему».
Почему Loki, а не сразу ELK
ELK и похожие стеки сильны, когда логов много, нужен сложный поиск по полям, аналитика событий, отдельная команда эксплуатации. Но для клуба, сети студий, небольшого e-commerce или офиса это часто перебор: больше компонентов, больше памяти, больше внимания к обслуживанию.
Loki устроен иначе: он не индексирует каждое слово в сообщении, а делает ставку на метки. Это снижает нагрузку и стоимость хранения, если дисциплинированно выбирать labels: сервис, хост, окружение, площадка. В Grafana можно рядом смотреть график нагрузки и логи нужного сервиса за тот же период.
Минус тоже есть. Loki не заменяет полноценную систему анализа событий и не любит хаос в метках. Если записывать в label номер заказа, email или уникальный идентификатор запроса, хранилище быстро распухнет. Поэтому настройка начинается не с установки пакета, а с договорённости: какие логи собираем и как их размечаем.
Сколько хранить и что это стоит
Главная ошибка — собирать всё навсегда. Для бизнеса важнее разумный горизонт: оперативное расследование свежих инцидентов, разбор после обновлений, подтверждение факта ошибки. Длинное хранение всех debug-сообщений редко оправдано.
Объём зависит не от названия системы, а от болтливости приложений. Веб-сервер с обычным трафиком пишет одно, приложение с включённым debug — совсем другое. Перед внедрением полезно посмотреть текущие размеры логов за несколько дней и убрать лишний шум. Часто это дешевле, чем расширять диск под бессмысленные записи.
Отдельно решите, что делать с персональными данными. Логи не должны становиться теневым хранилищем телефонов, токенов, адресов и содержимого заявок. Если сайт или интеграция пишет такое в ошибках, сначала исправляют формат логирования, а уже потом строят централизованный сбор.
С чего начать без «проекта на квартал»
Практичный старт — один Loki, Grafana, агент сборки логов и два-три источника: Nginx, приложение сайта, важная системная служба. Не надо сразу тащить туда каждый контейнер, роутер и кассу. Настройте алерты только на действительно полезные события: всплеск ошибок, недоступность источника логов, заполнение диска.
Дальше добавляйте сервисы по боли. Если часто разбираете интеграции с CRM — собирайте их. Если проблема в удалённых площадках — начните с VPN и ключевых серверов. Если у вас только один сервер и простые журналы уже покрывают задачи, честно оставьте Loki на потом.
Централизованные логи хорошо работают в паре с ИТ-аутсорсингом: бизнес не обязан читать LogQL, но подрядчик получает быстрый доступ к истории и меньше задаёт вопросов «а пришлите файл с сервера».
Если хотите понять, нужен ли вам Loki сейчас или достаточно привести в порядок обычные журналы, напишите нам. Посмотрим на контур, источники ошибок и предложим минимальный уровень без тяжёлой платформы ради платформы.